Search: #代码重构

  1. 《Uncle Bob 的 ub-mode:给 AI 编程助手装上"纪律开关"》

    《Uncle Bob 的 ub-mode:给 AI 编程助手装上"纪律开关"》

    标签:
    #软件工程 #AI编程辅助 #TDD #代码质量门禁

    总结:
    这是 Robert C. Martin(Uncle Bob)发布的一个 AI 智能体技能(agent skill),用于在 AI 编写或修改代码时强制执行严谨的软件工程纪律。它部分借鉴了 poteto-mode 的规则体系并加以精简,同时配套一组确定性的质量门禁工具(复杂度、重复率、变异测试),让"先让它能工作,再让它正确,最后持续练习"的原则可度量、可落地。

    文章要点:
    1. 核心理念分三层:先让它能工作(懒惰协议、TDD、先减后加、领域建模、边界与类型纪律等),再让它正确(修复根因、测试行为而非实现、持续重构),最后落实到日常练习(记日志、守护上下文窗口、小而有序的提交)。
    2. 规则部分借鉴并精简自 poteto-mode:作者明确说明 ub-mode 是 @poteto 规则集的删减版,与确定性工具搭配使用。
    3. 配套四个质量门禁工具仓库:crapper 计算圈复杂度与 CRAP 分数(要求 CRAP < 10),dryer 检测结构重复(相似度 ≥ 0.8 即需消除),mutator 做变异测试揪出"测试杀不死的活口",uml-viewer 可视化组件、覆盖率与依赖方向。
    4. 安装方式极简:只需把 SKILL.md 复制到所用 AI 工具的 skills 目录(如 /.claude/skills/ub-mode/),然后输入 /ub-mode 即可调用。
    5. 目标很明确:把 Uncle Bob 倡导的软件工艺原则变成 AI 编码时可检查、可强制执行的硬约束,而不是口头建议。

    URL:https://github.com/unclebob/ub-mode GitHub - unclebob/ub-mode
  2. 《Thorsten Ball:我对软件开发未来的16条判断》

    《Thorsten Ball:我对软件开发未来的16条判断》

    标签:
    #软件工程 #AI编程 #代码审查 #单元测试 #终端工具 #Token计算范式 #开源生态 #软件开发未来 #ThorstenBall

    总结:
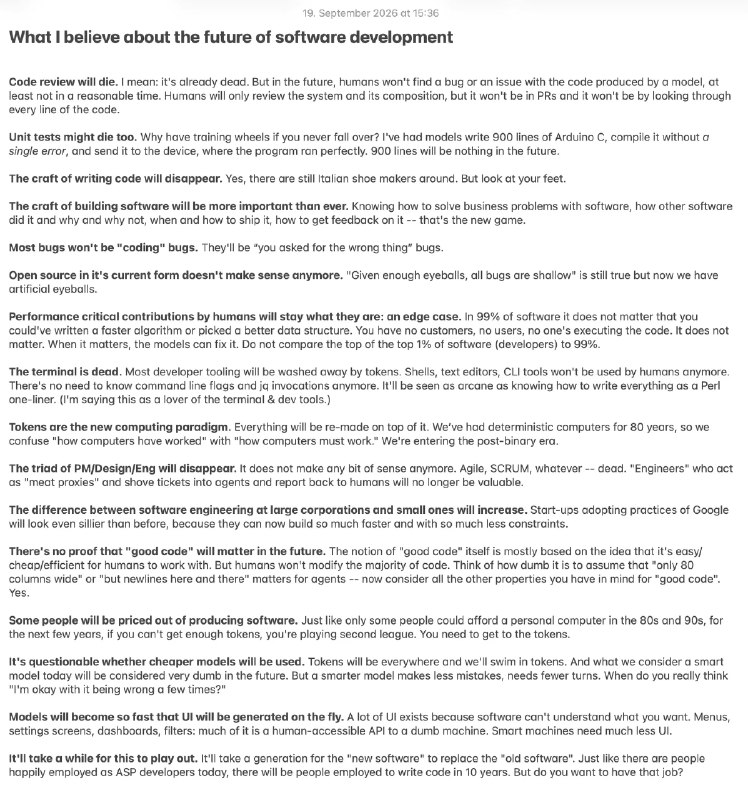
    2026年9月19日,知名开发者、《Writing An Interpreter In Go》作者、现供职于 Sourcegraph/Amp 的 Thorsten Ball 在 X 发布长文,抛出 16 条关于软件开发未来的判断。核心观点是:当 AI 写代码的可靠性足够高时,为人类防错而设计的整套工程实践(代码审查、单元测试、终端、命令行工具)都会逐渐失去必要性,工程师的价值将从"写代码的手艺"迁移到"理解业务、判断取舍、拿到反馈"上,而这一切需要一代人的时间完成。

    文章要点:
    1. 代码审查已死——人类不会再逐行 review 模型产出的代码,只会审查"系统与其组合方式"。
    2. 单元测试可能会消失——他让模型写 900 行 Arduino C 代码零错误一次通过,"摔不了跤就不需要护膝"。
    3. 写代码这门手艺会消失,但"造软件"(解决业务问题、判断何时上线、获取反馈)会比以往更重要。
    4. 大多数 bug 将不再是代码 bug,而是"你需求提错了"的 bug。
    5. 终端已死——Shell、编辑器、CLI 工具会被 token 冲刷,命令行知识将像 Perl 一行流一样变成"古老技艺"。
    6. Token 是新的计算范式,我们正在进入"后二进制时代",一切都会在它之上被重构。
    7. PM/设计/工程的铁三角和 Agile、Scrum 都会瓦解,只做"人肉代理"的工程师将不再有价值。
    8. 大小公司的工程差距会拉大——小团队比学大厂做法的初创公司跑得更快。
    9. "好代码"的标准(人类易读易维护)建立在人类要改代码的前提上,这个前提正在崩塌。
    10. 现有形式的开源不再合理——"众眼监虫"依然成立,但现在有了"人工眼睛"。
    11. 拿不到足够 token 的人会被排除在软件生产之外,token 是新的生产力门槛。
    12. 便宜模型未必有人用——更聪明的模型犯错少、轮次少,你未必愿意忍受它多错几次。
    13. 模型快到一定程度后,UI 会被实时生成,菜单、设置页、仪表盘这些"面向人类的 API"会大幅减少。
    14. 这场变革不会一夜发生——新旧范式更替需要一代人的时间,但反问是:"10年后还有写代码的工作,可你想要那份工作吗?"

    URL:https://x.com/thorstenball/status/2101305394190557466 Thorsten Ball (@thorstenball) on X

  3. 《十个防止 AI 代码泛滥的前端项目护栏》

    《十个防止 AI 代码泛滥的前端项目护栏》

    标签:
    #前端 #TypeScript #React #AI编程 #代码质量 #ESLint #测试策略 #CI_CD #代码审查 #工程实践

    总结:

    本文针对 AI 生成代码速度远超人类审查能力的前端项目,提供了一套实用的十项防护清单。核心思路是通过自动化工具链(类型系统、Linter、变异测试、CI 门禁)在代码合并前拦截机械性错误,而非依赖人工逐行审查。

    文章要点:

    1. 用 OpenAPI 契约替代手写类型:通过 Hey API 等工具从 OpenAPI 规范直接生成 TypeScript 类型、客户端和 Zod 校验,避免 AI 臆造不存在的 API 字段(如 user.fullName),让编译器在构建期就报错。

    2. 开启严格 TypeScript 配置:启用 noUncheckedIndexedAccess 等严格标志,让数组索引访问返回 T | undefined,迫使代码显式处理边界情况,减少 AI 常见的"想当然"代码。

    3. 把 Linter 当作行为过滤器:使用 SonarJS、react-you-might-not-need-an-effect、vitest/playwright 插件、jsx-a11y 等 ESLint 插件,自动拦截认知复杂度过高、不必要的 Effect、可访问性违规等问题。

    4. 设定架构层边界:使用 eslint-plugin-boundaries 或 dependency-cruiser 强制实施分层架构(如 UI 层不得直接访问 API 层),防止 AI 生成的代码逐渐退化为"GitHub 平均水平"的混乱结构。

    5. 将重复出现的错误转化为自定义 Linter 规则:当同一种 bug 第二次出现时,立即编写自定义 ESLint 规则禁止该模式。例如禁止在服务层函数中使用 Math.round 和 toFixed,避免双重取整导致的薪资计算错误。

    6. 把规则直接喂给 AI 模型:通过项目规则文件(如 .cursor/rules、CLAUDE.md)或技能文件(如 react-doctor),将项目约定、架构决策和禁止模式直接提供给 AI,让模型在生成代码时就遵循规范。

    7. 用变异测试验证测试有效性:使用 Stryker 故意破坏代码(翻转运算符、反转条件、交换返回值),检查现有测试是否能捕获这些变异。存活的变异体通常暴露"只测形状不测内容"的无效测试。一个项目约 4,700 个变异体在 6 分钟内完成扫描。

    8. 用 Knip 清理死代码:Knip 可以检测未使用的文件、导出和依赖,配合自定义可达性脚本填补其盲区,防止 AI 生成大量"以防万一"却无人调用的冗余代码。

    9. 用 jscpd 检测重复代码:AI 倾向于在不同地方生成几乎相同的逻辑,jscpd 能发现这些重复,提示抽象机会或错误的复制粘贴。

    10. 将所有检查强制设为 CI 门禁:上述所有工具(类型检查、Lint、测试、变异测试、重复检测)必须作为 CI 的强制通过项,而非可选建议,确保 AI 生成的代码无法绕过质量关卡。

    11. 成本与局限:这些护栏会产生噪音(误报)、规则过时和新人上手摩擦等成本,建议按"类型 → Lint → 测试 → CI"的顺序渐进式推行。同时需注意,这些检查只能捕获机械性错误,无法识别糟糕的品味或错误的抽象。

    URL:
    https://evilmartians.com/chronicles/ten-anti-ai-slop-moves-for-frontend-projects-going-faster-than-humans-can-review 10 anti-AI slop moves for frontend projects going faster than humans can review—Martian Chronicles, Evil Martians’ team blog

  4. 《Vitest 5.0 正式发布》

    《Vitest 5.0 正式发布》

    标签:
    #前端 #JavaScript #Vitest #测试框架 #单元测试 #性能优化 #BrowserMode #MockAPI #基准测试 #断言改进 #代码覆盖率

    总结:

    Vitest 5.0 于 2026 年 9 月 3 日正式发布,本次大版本以性能优化为核心,同时带来 Trace View 追踪视图、嵌套项目配置、vi.when 条件 Mock、基准测试重写等多项重要更新,并默认启用更严格的断言与 clearMocks 行为,要求 Vite >= 6.4.0 和 Node.js >= 22.12.0。

    文章要点:

    1. 性能大幅提升:通过共享 Vite 服务器、稳定的文件系统模块缓存、减少主进程与 worker 往返、加速 vm 池与浏览器模式等优化,整体测试速度提升 8%–53%,大型项目(1,280 模块)运行时间从 7.24s 降至 5.83s。

    2. **新增 vitest doctor 诊断工具**:自动运行替代配置并推荐更快的选项,同时默认输出性能提示,帮助用户发现配置瓶颈。
    Browser Mode 内置 Trace Viewew**:开启 browser.traceView 后,可记录交互、断言和 DOM 快照,支持逐步回放测试过程,便于调试 CI 失败。
    嵌套项目与配置继承继承**:内联项目默认继承根配置(无需 extends: true),被引用的配置文件可声明自己的 projects,支持多级嵌套结构。

    5. **新 API vi.when**:支持按参数定义不同的 Mock 返回值,支持深度相等和 expect.any() 等非对称匹配器,并可限制调用基准测试 API 重写API 重写**:bench 变为测试上下文 fixture,可在常规 test() 中使用,支持 fixtures、生命周期钩子、重试和断言,结果可存储并与基线定位器错误显示 ARIA 树ARIA 树**:浏览器模式下定位失败时,同时打印 ARIA 快照和 HTML,帮助快速理解 getByRole 等查询的匹配逻辑;定位器默认启用严格模式。

    8. **Mock Temporal API**:假计时器现在同时模拟 Temporal 和 Date,适用于 vi.useFakeTimers() 和 vi.setSystemTime()。

    9. **更严格的断言行为**:未 await 的异步断言(resolves、rejects 等)现在会导致测试失败;expect.poll 超时后拒绝并支持 AbortSignal 取消。

    10. **clearMocks 默认启用**:每个测试前自动清除 Mock 调用历史,避免测试间报告器统一输出目录。

    11. **报告器统一输出目录**:所有报告器输出集中到 .vitest 目录,减少 .gitignore 配置;HTML 报告器支持 singleFile 选项生成单文件报告。

    12. **其他实用改进**:新增 --repeats 选项重复运行测试以排查 flaky 测试;injectCjsGlobals 可禁用 CJS 全局注入;覆盖率工具切换到维护中的 @vitest/istanbuljs 包。

    13. **破坏性变更**:要求 Vite >= 6.4.0 和 Node.js >= 22.12.0,升级前建议查阅迁移指南。

    URL:
    https://vitest.dev/blog/vitest-5 Announcing Vitest 5.0

  5. 《W键在前端:技术与产品的协同进化》

    《W键在前端:技术与产品的协同进化》

    标签:#前端工程化 #Electron #Vite #代码重构 #Monorepo #TailwindCSS #ShadcnUI #ReactRouter #性能优化 #Medal

    总结:

    文章要点:
    1. **从"巨兽组件"说起**:作者用一张拥有30+ props的TextInput截图开场,生动展示了"反模式"组件的恐怖——职责混乱、默认值泛滥、DOM和自定义props杂糅,改一行代码要检查十个角落,开发体验堪比噩梦
    2. **宏观手术刀**:不硬啃旧组件,而是先换"土壤"——迁移Monorepo+PNPM解决版本混乱,引入Vite+HMR让Electron本地开发告别"停启地狱",CEO亲自下场当普罗米修斯点火
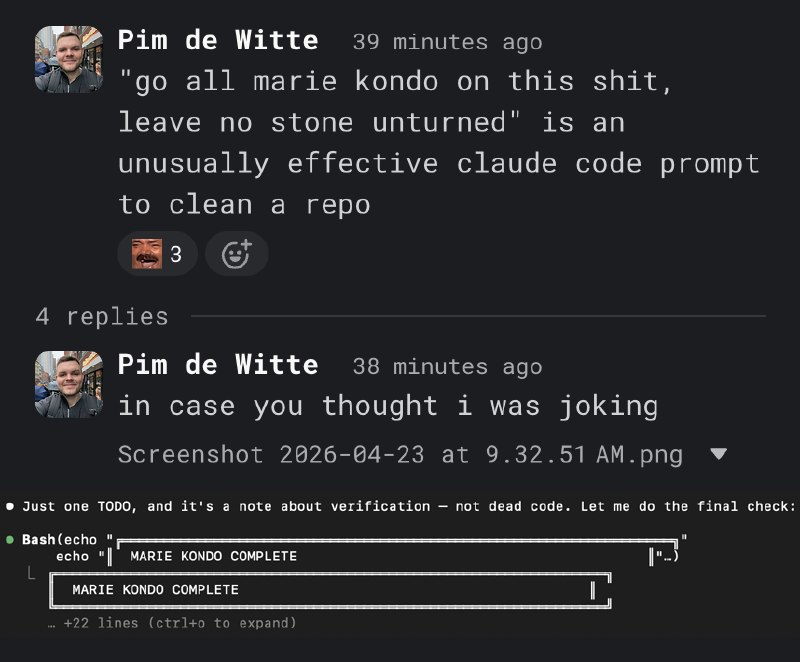
    3. **Marie Kondo式删代码**:统一导入路径(包名+清晰路径+文件后缀),减少barrel文件,让AI能精准识别"死代码"。结果疯狂删代码:单PR删除上万行,团队享受"五杀"快感,还提炼出跨平台通用包(utils/hooks/types)
    4. **生产环境统一Vite**:干掉Rollup,用Glob Imports做代码分割,配合路由级动态加载,i18n文件懒加载,最终渲染包从巨大体积瘦身到2.7MB,构建速度快到QA都惊呼"嗖嗖嗖"
    5. **组件层"换血"**:用Tailwind+Shadcn/Radix UI(后迁Base UI)替代Grommet和Styled Components,给旧组件挂ESLint"红牌"禁止令,同时写迁移指南。React Router v5→v7的大升级也顺势完成,现在搭个新页面只需一天

    URL:https://medal.tv/blog/posts/w-key-in-frontend-synergizing-technology-and-product W-Key in Frontend: Synergizing Technology and Product | Medal

  6. 《现代工程价值观:AI 时代的效率与品味》

    《现代工程价值观:AI 时代的效率与品味》

    标签:#软件工程 #AI编程 #代码审查 #团队管理 #技术栈 #开发者体验 #工程管理

    总结:
    作者 Christoph Nakazawa(cpojer)分享了他近半年完全依赖 AI 编码代理完成多个项目的实战经验,指出编程已从"手写代码"转向"指挥系统生成代码"。文章提炼了 AI 时代仍至关重要的五大工程价值观:强所有权、品味至上、严格约束与快速反馈、代码库即上下文、掌控技术栈,并强调管理需更技术化。作者用数据证明效率提升 3 倍,认为未来瓶颈不再是写代码,而是判断力与品味。

    文章要点:
    1. **AI 编码已成常态**:作者过去数月多个项目(Vite+、fate、Codiff、Athena Crisis 等)90%-100% 由 AI 编写,代码质量甚至超越手写,且能在几分钟内完成过去数周的工作
    2. **Codex CLI 是最佳搭档**:使用 GPT 5.5 high 配合 Codex CLI,配合"先写失败测试再修复"的策略,能极大提高一次性正确率;多项目并行时建议每个项目独立窗口,利用空间记忆提升效率
    3. **强所有权比代码更重要**:AI 放大了"懂行"与"不懂行"的差距,小团队(2-3 人)+ 清晰边界 + 独立仓库比大团队协作更高效,审查应聚焦对齐而非代码细节争论
    4. **品味是防"垃圾"泛滥的护城河**:AI 能全天候生成大量平庸代码,工程师的核心价值转向判断"什么值得做",团队应花更多时间思考方向而非盲目堆功能
    5. **严格约束 = 速度**:把代码规范、自动化测试、快速验证等"护栏"做得越严,AI 迭代越快(1 分钟 vs 60 分钟的差距);工具必须支持增量检查,避免随代码量增长而变慢
    6. **代码库即唯一上下文**:将设计文档、产品行为、决策记录全部沉淀在仓库内,让 AI 和人类都能快速理解;代码越简洁、越易读,AI 修复和迭代越高效
    7. **自研技术栈重新划算**:过去依赖第三方库是因为手写代码慢,现在 AI 降低了自研成本,掌控核心依赖能避免被外部框架绑架,获得完全的产品体验控制权
    8. **保留选择权(Option Value)**:任何架构改动都应保留未来大幅调整的可能性,AI 虽让重构变快,但把自己逼进死胡同依然难以脱身
    9. **管理必须更技术化**:执行成本降低后,管理者不能只做方向把控,必须保持领域 expertise,能亲自改代码、做技术决策,"技术型管理"(Tech Lead Management)将成为主流
    10. **效率数据惊人**:近 30 天日均提交 770 次、修改 15k 行代码,是两年前的 3 倍;过去手写巅峰一天 1200 行,现在 AI 辅助可达 10 倍且质量更高

    URL:
    https://cpojer.net/posts/modern-engineering-values Modern Engineering Values

  7. 《TypeScript 每个人都该知道的实用技巧》

    《TypeScript 每个人都该知道的实用技巧》

    标签:#TypeScript #前端开发 #代码质量

    总结:

    这是一份精心整理的 TypeScript 实战模式合集,涵盖 15 个核心技巧,从基础类型安全到高级类型体操,帮助开发者写出更安全、更可维护、更愉悦的代码。每条建议都配有简洁示例,强调"类型安全不等于运行时安全"这一关键认知,适合各阶段 TS 开发者查漏补缺。

    文章要点:

    1. 用 unknown 替代 any:强制做类型校验,守住类型安全的第一道防线,防止类型泄漏
    2. 让类型推断为你工作:减少不必要的显式注解,避免类型拓宽和维护负担,代码更简洁
    3. 用 satisfies 代替 as:既验证类型兼容性,又保留具体推断,比强制断言更安全
    4. 从值推导类型:用 as const + typeof 让运行时和编译时保持同步,告别手动维护两份定义
    5. 用可辨识联合建模不可能状态:用 status 标签区分状态,比松散的可选属性对象更可靠、更易扩展
    6. 用 never 做穷尽检查:在 switch 的 default 分支里赋值 never,让未来漏改直接变成编译错误
    7. 配置和常量用 as const:把对象属性收窄为字面量类型,比如 "dark" 而不是宽泛的 string
    8. 用类型谓语做可复用的收窄:把运行时检查写成 value is User 形式,让编译器理解你的守卫逻辑
    9. 从现有类型构建新类型:掌握 Pick、Omit、Partial 等工具类型,用变换思维代替重复定义
    10. 运行时校验外部数据:TypeScript 不验证 API 响应,配合 Zod 等库在边界做运行时校验
    11. 多数场景避免 enum:字面量联合类型通常更易重构、更易序列化、运行时行为更可控
    12. 优先使用可推断的泛型:好的 API 设计让用户无需手动传泛型参数,靠上下文自动推断
    13. 开启严格编译选项:strict、noUncheckedIndexedAccess 等标志是 TS 真正发挥价值的地方
    14. 学习模板字面量类型:用 `` /api/${string} `` 这类模式约束路由、事件名、CSS 工具类等字符串
    15. 类型安全 ≠ 运行时安全:TS 提升正确性,但不替代校验、不保证架构、不消除运行时错误

    URL:https://github.com/AllThingsSmitty/typescript-tips-everyone-should-know GitHub - AllThingsSmitty/typescript-tips-everyone-should-know: Practical TypeScript patterns for writing safer, more maintainable…

  8. 《用TanStack_Start构建博客(上篇)》

    《用TanStack_Start构建博客(上篇)》

    标签:#前端 #TanStack_Start #TanStack_Router #Server_Functions #静态预渲染 #Markdown博客 #代码高亮

    总结:
    本文通过实战案例演示如何使用 TanStack Start 框架构建一个 Markdown 博客系统。文章重点介绍了 Server Functions 解决同构加载器无法访问文件系统的问题、动态路由参数处理、以及使用 markdown-it 和 Shiki 实现带行号的高亮代码块,为开发者提供了完整的技术实现路径。

    文章要点:
    - TanStack Start 是基于 TanStack Router 的轻量级服务端框架,支持 SSR、API 端点和 Server Functions
    - 使用 import.meta.glob 动态扫描 Markdown 文件,配合 gray-matter 解析文章元数据
    - Server Functions 是同构应用的关键——无论 loader 在服务端还是客户端运行,都能保证文件读取逻辑始终在服务端执行
    - 动态路由通过 $slug.tsx 文件命名实现,配合 createFileRoute 和 head 函数设置页面标题
    - 使用 markdown-it + Shiki 实现代码高亮,通过自定义 transformer 支持 line-numbers 语法标记,结合 CSS counter 渲染行号
    - 文章预告下篇将介绍静态生成和部署策略

    文章URL:https://frontendmasters.com/blog/building-a-blog-in-tanstack-part-1-of-2/ Building a Blog in TanStack (Part 1 of 2)

  9. 《垂直代码库:告别按类型分层,拥抱按业务域组织》

    《垂直代码库:告别按类型分层,拥抱按业务域组织》

    标签:#前端 #代码组织 #架构设计 #Monorepo #React #软件工程

    总结:

    本文主张前端代码库应从"水平分层"(按 components/hooks/utils 技术类型划分)转向"垂直切片"(按业务域/功能域组织)。作者以 Sentry 代码库十年演进为例,指出水平分层会导致代码分散、认知负荷高、耦合混乱;而垂直组织将同一业务域的组件、工具、类型内聚到一起,配合 Monorepo 的显式边界(exports/eslint-plugin-boundaries),能显著提升可维护性。虽然确定正确的垂直划分需要更多团队沟通,但这是支撑代码库长期演进的必要投资。

    文章要点:

    - 水平分层的隐患:把代码按 components / hooks / utils / types 分类虽然上手简单,但随着项目膨胀,同一业务逻辑会被拆得七零八落——比如 PageFilters 的组件、类型、工具函数散落在三个目录,改一个小需求要跳来跳去, cognitive load 直接拉满
    - 垂直切片的核心思想:不按"技术类型"而按"业务域"分组,把同一个功能域(如 dashboard、profiling、billing)相关的组件、Hook、工具、类型全部收进一个目录;就像当年我们把 HTML/CSS/JS 从三层文件合并成组件一样,这次是更高维度的"关注点内聚"
    - 与团队结构天然对齐:现代产品团队通常是端到端的功能团队(dashboard 团队、replay 团队),垂直代码结构让 CODEOWNERS 和包边界直接对应团队职责,谁负责什么一目了然
    - 解决跨域复用焦虑:不是所有代码都严格属于某个页面,像 PageFilters 这种被多页面使用的通用能力,完全可以作为独立垂直域存在;关键是按"逻辑关联"而非"物理位置"来划分
    - 用边界守护架构:垂直化后还需降低耦合,推荐通过 Monorepo + package.json#exports 显式暴露公共 API,或借助 eslint-plugin-boundaries 禁止深路径导入,把"私有实现"真正保护起来
    - 没有银弹,但值得投入:确定合理的垂直域确实比"丢进 utils"更难,也可能出现不同团队重复造轮子;但作者认为这恰恰促进了团队沟通,而沟通本就是软件工程最难也最重要的部分

    文章URL:

    https://tkdodo.eu/blog/the-vertical-codebase The Vertical Codebase

  10. 《从写代码到管 Agent:斯坦福首门 AI 软件开发课的启示》

    《从写代码到管 Agent:斯坦福首门 AI 软件开发课的启示》

    标签:#AI #Agent #软件工程 #斯坦福 #职业发展 #人机协作 #代码质量

    总结

    本文是对斯坦福讲师 Mihail Eric 访谈的解读,他是全美首门 AI 原生软件开发课程 CS146S 的负责人。文章分析了初级开发者面临的"三重风暴"(裁员潮、毕业生激增、AI 替代压力),提出 AI 时代工程师的核心竞争力已从写代码转向"管理 Agent"——即编排多个 AI Agent 完成复杂任务的能力。同时强调 Agent 友好的代码库需要充分的测试覆盖、一致的文档和清晰的设计模式,这些本质上也是对人友好的工程实践。文章还指出资深开发者往往因路径依赖抗拒 AI 工具,而初级工程师的"无知无畏"反而成为快速适应新范式的优势。

    文章要点:

    - **初级开发者的三重困境**:COVID 后企业裁员 20-30%、CS 毕业生十年翻倍、雇主倾向"少招人+AI"策略,叠加导致新人求职难度激增
    - **Agent 编排是顶级技能**:能同时管理多个 Agent 的工程师属于顶尖 0.1%,但应从单个 Agent 开始逐步增加,避免盲目追求数量
    - **上下文切换是核心挑战**:管理多 Agent 需要频繁切换注意力并记住各任务进度,这与管理人类团队的能力高度相似
    - **Agent 友好代码库三要素**:充分的测试覆盖(作为显式合约)、README 与代码一致性、统一的设计模式,Agent 会在错误基础上快速复合错误
    - **品味决定软件质量**:功能性软件与卓越软件的分界在于"最后一公里"的打磨,顶尖工程师在发现可能性时加速而非完成任务即停止
    - **初级工程师的独特优势**:没有历史包袱,学习 AI 工具更快;"无知无畏"的特质使其敢于挑战行业难题,这是创业所需的完美品质
    - **避免过度工程化陷阱**:AI 让构建变得太容易,可能导致造出精美但无人需要的产品,需先验证需求再动手开发

    文章URL:https://baoyu.io/blog/2026-02-27/from-writing-code-to-managing-agents 从写代码到管 Agent:斯坦福首门 AI 软件开发课的讲师说,大多数工程师还没准备好