Search: #React

  1. 《用 React Suspense 面板调试 Suspense》

    《用 React Suspense 面板调试 Suspense》

    标签:
    #前端开发 #React
    #React_Developer_Tools #Suspense面板 #加载调试 #骨架屏 #布局抖动

    总结:
    本文演示了如何用 React Developer Tools 8.0 新增的 Suspense 面板,排查一个仪表盘页面中"销售统计卡延迟约 2 秒才出现"和"内容到达时快速操作区被顶下去"两个问题。通过时间轴回放、Inspect Suspense Nodes、Suspended by 和强制回退功能,作者定位到负责延迟的边界和 Promise,并把骨架屏改成与真实内容形状、尺寸一致,从而消除了布局抖动。

    文章要点:
    1. Suspense 面板在 React Developer Tools 8.0 中默认启用,配合 React 19.2+ 的开发模式构建能显示最完整的信息。
    2. 面板分为四个区域:工具栏(Inspect Suspense Nodes 可直接从页面点选边界)、Minimap(页面边界的可视化地图,颜色区分渲染环境)、时间轴(每步对应一次初始绘制或边界揭示,可回放页面状态)、检查器(查看 Suspended by、props 和渲染来源)。
    3. 通过逐步回放时间轴,发现布局抖动发生在统计卡片揭示的那一刻,因为卡片比灰色占位块高,把上方的 QuickActions 顶了下去——嵌套边界只控制揭示顺序,并不为内容预留空间。
    4. 用 Inspect Suspense Nodes 从页面内容反查所属边界,比在大页面里挨个找 Minimap 区域更快;找不到时记得关闭 Unique Suspenders 过滤器。
    5. Suspended by 显示边界等待的对象、耗时和解析结果,能把排查范围缩小到数据、代码或资源,但无法解释为什么会慢。
    6. 检查器里的"暂停所选组件"按钮可以随时把边界强制切回 fallback,方便把骨架屏和真实内容并排对比,无需改代码或限速网络。
    7. 修复方法:让骨架屏复刻真实布局——直接渲染四张真实卡片和标签,只把查询得到的数值换成等高的占位行;重放时间轴后快速操作区不再移动。

    URL:https://certificates.dev/blog/debugging-suspense-with-the-react-suspense-panel Debugging Suspense with the React Suspense Panel
  2. 《在 GitHub Copilot 应用中流畅渲染超大 Pull Request》

    《在 GitHub Copilot 应用中流畅渲染超大 Pull Request》

    标签:
    #软件工程 #前端性能优化 #PullRequest #虚拟化渲染 #React #测量调度 #滚动锚定 #性能监控

    总结:
    文章介绍了 GitHub Copilot 应用如何重构 Pull Request 视图,使其能够流畅处理包含 2,200 个文件、超过 100 万行代码变更和 400 多条内联评论的超大型 PR。核心挑战在于评论高度的动态性——与代码行不同,评论高度取决于 Markdown 换行、可展开区块、回复框和图片加载等渲染时才能确定的因素。团队通过分离确定性与动态几何、实现智能测量调度器、采用滚动锚定技术,并建立自动化测量循环来解决这一问题,最终实现了百万行 diff 的流畅浏览体验。

    文章要点:

    1. 代码与评论的几何分离:代码行高度固定且可预先计算,而评论高度动态变化。团队将文档高度分为确定性代码高度(精确前缀和)和动态块高度(估算后测量),两者独立管理,避免评论调整时重建整个代码几何。

    2. 智能测量调度器:放弃每块一个 ResizeObserver 的方案(会触发反馈循环),改为单一的空闲和滚动门控测量通道。仅在视口附近约 2400px 范围内进行测量,屏幕上的块优先批量读取,离屏块最多做一次有限渲染,超过视口高度的块跳过测量。

    3. 滚动锚定技术:当测量高度与估算不符时,通过身份而非像素来校正——记录用户锚定的行或块,应用高度增量后,将同一锚点解析到新像素位置并滚动,确保用户视线不跳动。区分用户滚动与程序滚动,避免侧边栏切换等操作误触发保护机制。

    4. 数据管道优化:流式传输结构优先于内容,文件树和元数据在文档加载时即可渲染;语法高亮在主线程外运行,行先以纯文本显示;释放文档时保留最近几个 diff 的缓存,平衡内存与返回时的加载速度。

    5. 自动化测量循环:建立"变更→测量→改进"的无人值守循环,包括无头探针车道(声明式流程 + 生产环境插桩)和自动驾驶仪(驱动真实桌面应用),通过健康信号(如无未填充间隙、评论块非空)自动检测问题,实现机械式调试而非人工复现。

    URL:
    https://github.blog/engineering/user-experience/rendering-huge-pull-requests-in-the-github-copilot-app/ Rendering huge pull requests in the GitHub Copilot app

  3. 《框架还重要吗?》

    《框架还重要吗?》

    标签:
    #编程 #Web开发 #AI编程 #前端框架 #React #软件工程 #技术趋势 #VibeCoding

    总结:

    这是一篇探讨在 AI 编程时代 Web 框架是否仍然重要的深度分析文章。作者 Brooks Lybrand 作为拥有三年开源框架开发经验的前端工程师,针对"模型已经足够好,框架选择不再重要"的流行观点进行了系统性反驳,论证了框架在提供抽象、结构和约束方面的核心价值,并呼吁行业继续创新和构建新框架。

    文章要点:

    1. **对"React 已赢"论的质疑**:作者指出当前流行观点认为由于 LLM 训练数据中 React 代码最多,模型最熟悉 React,因此无需尝试其他框架。但他认为这种逻辑存在矛盾——如果框架真的不重要,那连 React 都不需要,直接用 Web Components 或让 AI 生成原生代码即可。

    2. **框架的本质价值**:作者将框架的价值精炼为三点:**提供抽象(Abstractions)、结构(Structure)和约束(Constraints)**。这些价值不仅适用于人类开发者,对 AI 编程同样关键——良好的抽象能避免 AI 重复造轮子或创建混乱的临时方案;清晰的结构帮助 AI 生成可维护的代码;明确的约束(如类型检查、测试)能防止 AI 在迭代中破坏系统。

    3. **AI 时代框架的隐性存在**:引用 React 核心团队成员 Ricky Hanlon 的观点"你要么使用框架,要么构建框架",作者强调即使不显式选择框架,AI 在生成代码时也会隐式地创建框架。与其让 AI 生成一个缺乏维护、充满临时补丁的"隐性框架",不如使用经过实战检验、文档完善的开源框架。

    4. **开发者体验(DX)的重构**:通过分析 HMR(热模块替换)、TypeScript 和 useEffect 等具体技术,作者说明某些传统 DX 功能对人类开发者的价值正在转变,但对 AI 编程仍至关重要。例如 TypeScript 的类型约束能有效防止 AI 在复杂应用中引入错误,而 useEffect 这类强大但易误用的抽象则应该避免让 AI 随意使用。

    5. **框架战争的终结与新机遇**:作者认为 2013-2024 年的"框架战争"已经结束,人们不再渴望为框架争论,但这不意味着框架不再重要。他指出当前框架领域仍存在明显不足,特别是缺乏真正全栈、基于 Web 标准、易于 AI 协作且代码可理解的 JavaScript 框架。

    6. **对未来的呼吁**:尽管承认 AI 正在重塑软件开发,且没人知道其长期影响,作者仍坚持认为认为"所有问题都已解决"是一种颓废的态度。他呼吁继续构建新框架,探索更好的抽象和模式,而不是停留在"现有框架足够好"的舒适区。

    URL:
    https://brookslybrand.com/posts/do-frameworks-matter-anymore/

    > 个人觉得有点片面化,remix 脱离 react 转而用 preact 自创轮子

  4. 《十个防止 AI 代码泛滥的前端项目护栏》

    《十个防止 AI 代码泛滥的前端项目护栏》

    标签:
    #前端 #TypeScript #React #AI编程 #代码质量 #ESLint #测试策略 #CI_CD #代码审查 #工程实践

    总结:

    本文针对 AI 生成代码速度远超人类审查能力的前端项目,提供了一套实用的十项防护清单。核心思路是通过自动化工具链(类型系统、Linter、变异测试、CI 门禁)在代码合并前拦截机械性错误,而非依赖人工逐行审查。

    文章要点:

    1. 用 OpenAPI 契约替代手写类型:通过 Hey API 等工具从 OpenAPI 规范直接生成 TypeScript 类型、客户端和 Zod 校验,避免 AI 臆造不存在的 API 字段(如 user.fullName),让编译器在构建期就报错。

    2. 开启严格 TypeScript 配置:启用 noUncheckedIndexedAccess 等严格标志,让数组索引访问返回 T | undefined,迫使代码显式处理边界情况,减少 AI 常见的"想当然"代码。

    3. 把 Linter 当作行为过滤器:使用 SonarJS、react-you-might-not-need-an-effect、vitest/playwright 插件、jsx-a11y 等 ESLint 插件,自动拦截认知复杂度过高、不必要的 Effect、可访问性违规等问题。

    4. 设定架构层边界:使用 eslint-plugin-boundaries 或 dependency-cruiser 强制实施分层架构(如 UI 层不得直接访问 API 层),防止 AI 生成的代码逐渐退化为"GitHub 平均水平"的混乱结构。

    5. 将重复出现的错误转化为自定义 Linter 规则:当同一种 bug 第二次出现时,立即编写自定义 ESLint 规则禁止该模式。例如禁止在服务层函数中使用 Math.round 和 toFixed,避免双重取整导致的薪资计算错误。

    6. 把规则直接喂给 AI 模型:通过项目规则文件(如 .cursor/rules、CLAUDE.md)或技能文件(如 react-doctor),将项目约定、架构决策和禁止模式直接提供给 AI,让模型在生成代码时就遵循规范。

    7. 用变异测试验证测试有效性:使用 Stryker 故意破坏代码(翻转运算符、反转条件、交换返回值),检查现有测试是否能捕获这些变异。存活的变异体通常暴露"只测形状不测内容"的无效测试。一个项目约 4,700 个变异体在 6 分钟内完成扫描。

    8. 用 Knip 清理死代码:Knip 可以检测未使用的文件、导出和依赖,配合自定义可达性脚本填补其盲区,防止 AI 生成大量"以防万一"却无人调用的冗余代码。

    9. 用 jscpd 检测重复代码:AI 倾向于在不同地方生成几乎相同的逻辑,jscpd 能发现这些重复,提示抽象机会或错误的复制粘贴。

    10. 将所有检查强制设为 CI 门禁:上述所有工具(类型检查、Lint、测试、变异测试、重复检测)必须作为 CI 的强制通过项,而非可选建议,确保 AI 生成的代码无法绕过质量关卡。

    11. 成本与局限:这些护栏会产生噪音(误报)、规则过时和新人上手摩擦等成本,建议按"类型 → Lint → 测试 → CI"的顺序渐进式推行。同时需注意,这些检查只能捕获机械性错误,无法识别糟糕的品味或错误的抽象。

    URL:
    https://evilmartians.com/chronicles/ten-anti-ai-slop-moves-for-frontend-projects-going-faster-than-humans-can-review 10 anti-AI slop moves for frontend projects going faster than humans can review—Martian Chronicles, Evil Martians’ team blog

  5. 《Oxlint 原生集成 React Compiler:Lint 速度提升 3 倍,Rust 工具链再进一步》

    《Oxlint 原生集成 React Compiler:Lint 速度提升 3 倍,Rust 工具链再进一步》

    标签:
    #前端开发 #React #Rust #Oxlint #性能优化 #编译器

    总结:

    Oxlint 在 v1.79.0 中正式原生集成了 React Compiler 的 22 条 lint 规则,无需 Babel 管道即可在 Rust 层直接运行。这意味着开发者可以在 lint 阶段就捕获 React Compiler 的 bailout(回退)情况,而 lint 任务耗时从约 29.2 秒骤降至 9.1 秒(3.2 倍加速),若去掉其他 JS 插件甚至可达 11 倍。作者强调:使用 React Compiler 时,启用全部 lint 规则是"不可争议的前提条件",因为一次 bailout 就可能导致性能严重退化(如作者主页动画卡顿)。同时,oxc 的 Rust 版 React Compiler 构建时转换也已接近可用,比原版快约 2 倍。

    文章要点:

    1. React Compiler 的 Rust 重写已成官方版本 — React 团队近期发布了 Rust 重写的 React Compiler,作为新的 canonical 版本。作者已在 AI 建站工具 Outlyne 中使用近一年,彻底告别手动 useCallback/useMemo。

    2. 作者已全面迁移到 oxc 生态 — Rollup → Rolldown、ESLint → Oxlint、Prettier → oxfmt、Jest → Vitest,整体工具链已 Rust 化,但 React Compiler 的 lint 插件一直是瓶颈。

    3. 旧方案的痛点:Babel 管道拖慢 lint 3 倍 — 此前通过 Oxlint 的 JS 插件支持运行 React Compiler linter,需要先跑 Babel 再跑 Compiler 核心构建 AST,导致 lint 任务耗时从 9 秒暴涨到 29 秒。

    4. Oxlint v1.70.0 起引入原生支持 — 新增 nursery 规则 react/react-compiler,直接在 Rust 中运行 React Compiler,无需 Babel。v1.79.0 正式发布 22 条 Compiler 驱动的规则,覆盖 React 规则的验证。

    5. 推荐配置:correctness + 枚举剩余规则 — 启用 correctness 类别可覆盖 12 条规则,再手动列出其余 10 条。若启用 restriction 类别则自动再纳入 5 条,suspicious 纳入 4 条,perf 纳入 1 条。

    6. 速度实测:3.2 倍到 11 倍提升 — 原生规则下 lint 从 29.2s → 9.1s;若同时去掉无原生替代的 JS 插件(如 perfectionist),可进一步降至 2.6s,实现 11 倍加速。

    7. 构建时转换也在推进中 — oxc 已合并原生构建时 transform,但 Rolldown/Vite 曾因二进制体积增加 17% 而暂时回退。oxc-transform-react v0.0.1 已发布,比原版 Rust Compiler 快约 2 倍,source map 已修复,支持 fast refresh,作者已在生产环境测试。

    8. 迁移门槛极低 — 只需 lint 层面改动,不影响构建步骤。可用 npx @oxlint/migrate 自动迁移 ESLint flat config,或让 LLM 帮忙。甚至可以先并行跑 Oxlint 和 ESLint,只替换 React Compiler 插件就能提速。

    9. 一个常见陷阱:props 重新赋值 — function MyComponent({ value }) { value = value ?? fallback; } 这种写法会让整个组件被 Compiler 跳过(bailout),导致性能退化。建议用解构重命名解决,同时开启 eslint/no-param-reassign 规则。

    10. 作者的底线原则 — "React Compiler without linting all bailouts considered unsafe"(不 lint 所有 bailout 的 React Compiler 视为不安全)。一次 bailout 曾导致其首页动画 placeholder 卡顿、视觉破碎。

    URL:
    https://blog.master.dev/react-compiler-linting-just-got-a-rust-native-speedup-in-oxlint/ React Compiler Linting Just Got a Rust-Native Speedup in Oxlint

  6. 《Shadscan:shadcn 应用的确定性 UI 审计工具》

    《Shadscan:shadcn 应用的确定性 UI 审计工具》

    标签:#前端 #shadcn/ui #React #UI审计 #CLI工具 #可访问性 #CI/CD #AI_Agent

    总结:
    Shadscan 是一款面向 React/shadcn 应用的静态 UI 审计 CLI 工具,通过 59 条确定性规则从 Foundation、Interaction、States、Accessibility、Forms 和 Production Polish 六个维度为应用打分(0-100),无需启动应用或调用 AI 即可在终端和 CI 中完成审计。它支持生成 JSON 报告、AI Agent 修复指令(--prompt)和 GitHub Action 集成,适用于 Next.js、React Router、TanStack Start、Astro 等多种框架,并支持 monorepo 多包扫描。

    文章要点:
    1. 零侵入式审计:无需启动应用、修改文件或调用 AI 模型,纯静态分析即可给出可复现的评分结果,适合嵌入 CI 流水线。
    2. 六维评分体系:涵盖基础配置、交互体验、状态处理、无障碍访问、表单输入和生产级打磨,共 59 条规则,每条都附带证据和修复建议。
    3. AI Agent 友好:支持 --prompt 生成可直接粘贴给 Claude Code、Codex CLI 等编码 Agent 的修复计划,也支持 --apply 直接唤起本地 Agent 执行。
    4. 多框架与 Monorepo 支持:自动识别 Next.js App/Pages Router、React Router、TanStack Start、Astro、Vite 等框架,智能区分应用包和库包,避免设计系统被误扣分。
    5. GitHub Action 一键集成:提供复合 Action,可自动写评分到 Job Summary、设置分数门槛拦截 CI,还能持续更新跟踪 Issue 并嵌入 Agent 修复指令。

    URL:https://www.shadscan.com shadscan: Audit shadcn apps for UI fundamentals

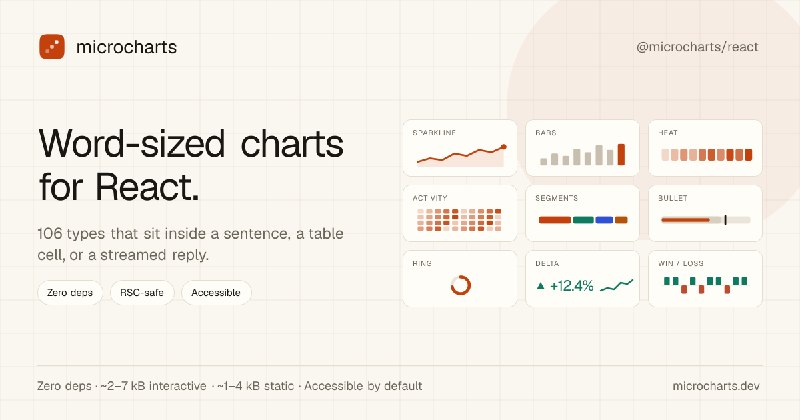
  7. 《Microcharts:一句话里就能塞下的React微图表库》

    《Microcharts:一句话里就能塞下的React微图表库》

    标签:#前端 #React #数据可视化 #图表库 #性能优化 #无障碍 #ServerComponents

    总结:
    Microcharts是一个专为React设计的微图表库,提供106种图表类型,单个图表gzip后仅2.18-7KB(中位数5.25KB),零依赖。它主打"词级图表"理念——图表小到可以嵌入句子、表格单元格和KPI卡片中,无需坐标轴和图例,由上下文文字承载含义。支持服务端组件静态渲染(0KB客户端JS)、自动生成无障碍alt文本、单色系主题系统,并能在错误数据下优雅降级。

    文章要点:
    1. 小到离谱:中位数图表仅5.25KB gzip,最大7KB,零运行时依赖,React只是peer dependency,比通用图表库(如Recharts 106KB共享内核)轻了整整101KB
    2. 一句话装得下:图表设计为"词级尺寸",可以直接嵌入正文、表格单元格、KPI卡片甚至打印报告,读者不用离开句子就能理解数字
    3. 106种图表统一API:传一个data数组就搞定,domain、color、title在每个图表里含义一致,TypeScript类型完备,编辑器能自动补全
    4. 静态渲染零负担:在Server Component里渲染时完全不产生客户端JS,hydrate成本为0,对性能敏感场景极其友好
    5. 坏数据也能优雅处理:NaN、空数组、单一数值都不会报错,会自动渲染成点、空白或水平线,不用写try/catch兜底
    6. 无障碍开箱即用:自动生成alt文本(如"趋势上升27%,范围128到163"),每个图表一个tab焦点,支持方向键浏览,色盲安全配色和RTL都内置
    7. 单色系主题系统:给一个accent主色就能自动推导出完整配色(包括正负色、分类色、暗色模式),整个页面一键换肤

    URL:https://microcharts.dev/ microcharts — Word-sized charts for React.

  8. 《TanStack_Markdown与TanStack_Highlight发布:让技术文档渲染回归轻量》

    《TanStack_Markdown与TanStack_Highlight发布:让技术文档渲染回归轻量》

    标签:#前端 #TanStack #Markdown渲染 #语法高亮 #性能优化 #React #TypeScript

    总结:
    TanStack发布两个新库:Markdown解析器与Highlight语法高亮,专为技术博客、文档和AI流式输出设计。通过将Markdown解析与语法高亮解耦,采用轻量级AST和语义化CSS类,将文档页脚本体积从1.1MiB大幅缩减至约27KiB,彻底摆脱了对React_Server_Components的依赖,实现了"让内容回归内容"的极简渲染理念。

    文章要点:
    1. 痛点很真实:原来tanstack.com的文档页光是语法高亮就占了358KiB,加上Shiki、WASM、主题等,读个页面像下载小型出版系统,不得不靠RSC把负担藏到服务器端
    2. 两个库分工明确:Markdown负责把内容解析成可序列化的普通数据树,Highlight负责把已知语言转成带语义CSS类的HTML,互不依赖,按需组合
    3. 体积真的小:Markdown解析器仅4.9KB(gzipped),HTML渲染器约6.7KB,Highlight核心才1.7KB,25种语言全包也才8KB,零运行时依赖
    4. 暗色模式超优雅:Highlight输出一套带th-语义类的HTML,主题通过CSS变量切换,不用重新高亮,明暗切换只是一次CSS操作
    5. AI流式输出有新招:不用维护复杂的增量解析状态,每次收到新文本就同步重新解析,已完成块保持稳定,未完成的标题列表不会留空占位
    6. 已经扛住实战考验:这两个库已全面替换tanstack.com的文档和博客渲染,测试覆盖333个真实文档fixtures,不是玩具是生产力工具

    URL:https://tanstack.com/blog/introducing-tanstack-markdown-and-highlight Introducing TanStack Markdown and TanStack Highlight | TanStack Blog

  9. 《前端状态管理的真相与迷思》

    《前端状态管理的真相与迷思》

    标签:#前端 #Web开发 #React #状态管理 #Redux #Zustand #Jotai #MobX #CRDT #离线优先 #实时协作 #前端架构

    总结:
    作者犀利指出,React生态中流行的"状态管理"库(Redux、Zustand、MobX等)本质上只是状态传播与通知系统,而非真正的状态管理。真正的状态管理必须包含时间维度与顺序概念,能正确应用变更并解决冲突。作者推荐转向Y.js、Zero、Fluid等基于CRDT或OT的时序感知系统,它们天然支持离线优先与实时协作,才是前端数据层的未来方向。

    文章要点:
    1. 那些我们天天用的Redux、Zustand、MobX,本质上更像"消息广播员"而不是"状态管家"——它们能通知组件更新,却搞不定时间顺序和冲突解决
    2. React自己也不是状态管理系统,整个前端圈把这个词用得太随意,导致大家一直在用错误的工具硬撑复杂场景
    3. 真正的状态管理必须懂"时间"和"顺序",就像分布式系统用向量时钟给事件排队,没有时间概念就谈不上管理
    4. 值得庆幸的是,Y.js、Zero、Fluid这类基于CRDT和操作变换的工具已经相当成熟,它们天生会处理冲突,离线和实时协作都是顺手的事
    5. 当我们把数据层从"发通知"升级到"管时序"后,离线优先和实时协作不再是昂贵的附加功能,而是正确架构带来的自然馈赠

    URL:
    https://infrequently.org/2026/07/state-management

  10. 《前端框架基准测试平台》

    《前端框架基准测试平台》

    标签:#前端 #Web开发 #FrameworkBenchmarks #PerformanceTesting #JavaScriptFrameworks #React #Vue #Svelte #SolidJS #Preact #Qwik #Lit #Angular #BundleSize #BuildTime #LighthouseScores #HMR #NPMStats #StackMatch

    总结:
    这是一个全自动化的前端框架基准测试平台,由开发者Alicia Sykes维护。项目用同一个天气应用在React、Vue、Svelte等12+个主流框架中实现,每晚自动跑分对比包体积、Lighthouse评分、加载速度、CPU内存占用、构建时间及HMR热更新速度。还整合了GitHub和NPM社区数据,并自带Stack Match智能推荐工具。所有原始数据开源可下载,帮你告别选型纠结!

    文章要点:
    1. 同一个天气应用,12+种框架实现——React、Vue、Svelte、Solid.js、Qwik、Lit等主流选手全部到场,公平对决
    2. 每晚自动跑分,数据新鲜出炉——包体积、Lighthouse性能分、FCP/LCP/TTI加载指标、CPU内存占用、构建时间、HMR速度全覆盖
    3. 社区数据一目了然——GitHub Stars、NPM月下载量、依赖数量、维护者人数、TS支持情况、许可证信息全整理好了
    4. 自带Stack Match智能推荐工具——填填项目偏好,就能get最适合你的框架,选型不再拍脑袋
    5. 完全开源透明——所有原始数据以JSON格式开放下载,测试用Playwright统一验证,结果可信可复现

    URL:[https://framework-benchmarks.as93.net/](https://framework-benchmarks.as93.net/) Framework Benchmarks

  11. 《Brainless:复刻AI编码助手终端UI的shadcn组件库》

    《Brainless:复刻AI编码助手终端UI的shadcn组件库》

    标签:#前端 #shadcn #React #AI终端UI #ClaudeCode #Codex

    总结:
    Brainless 是一个 shadcn/ui 组件注册表,提供一套可复用的 React 组件,精准还原 Claude Code、OpenAI Codex 和 Grok 等 AI 编码助手的终端风格界面。开发者可通过 npx shadcn@latest add 一键安装,快速构建具有"Agent 味"的交互界面。

    文章要点:
    1. 精准还原终端风格:组件库完整复刻了 Claude Code、Codex、Grok 等主流 AI 编码助手的终端界面,包括待办列表、计划展示、思考过程等核心 UI 元素
    2. 像素级细节还原:从实际终端截图出发,逐帧对比"已发布"与"捕获"版本,修正了行间距、符号对齐、颜色处理等细节差异,确保视觉体验与真实终端一致
    3. shadcn 生态原生支持:作为官方注册表组件,可直接通过 shadcn CLI 安装,与现有项目无缝集成,无需额外配置
    4. 开源可扩展:代码托管在 GitHub,开发者可自由查看源码、提交改进,甚至基于其设计思路构建自己的 Agent 风格界面

    URL:https://brainless.swerdlow.dev/ brainless

  12. 《DSSSP:React音频均衡器与滤波器可视化库》

    《DSSSP:React音频均衡器与滤波器可视化库》

    标签:#前端 #React #音频可视化 #SVG #WebAudio

    总结:
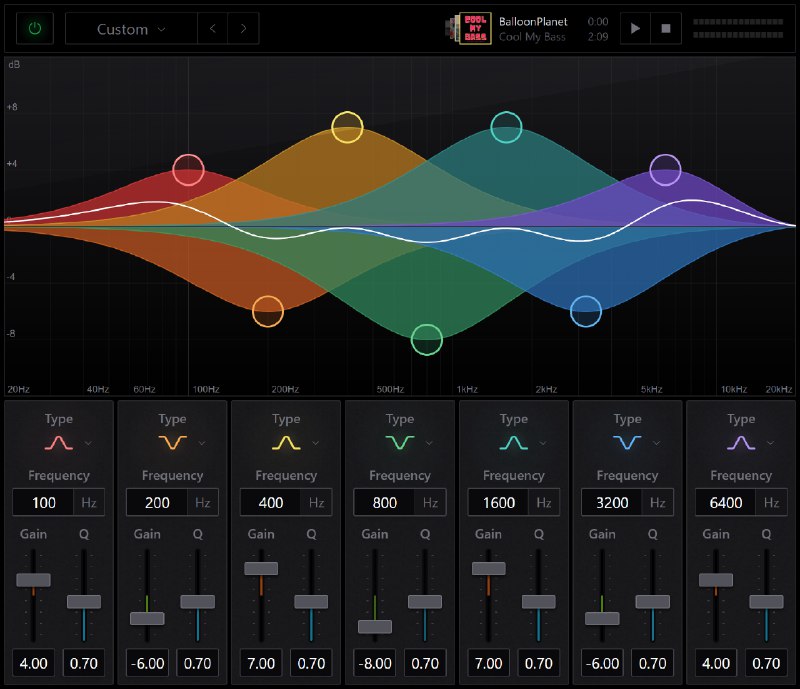
    DSSSP 是一个基于 SVG 的 React 组件库,用于可视化音频频率响应图和交互式控制音频滤波器。它将专业桌面音频软件的参数调节功能移植到 Web 环境,支持拖拽调节增益、频率、Q值等参数。

    文章要点:
    1. 专业音频可视化:基于 SVG 渲染对数频率图谱,精准呈现音频频谱响应曲线,适合音频编辑工具开发
    2. 交互式滤波器控制:支持拖拽操作和直接属性更新,可调节增益(Gain)、频率(Frequency)、Q值(Q-Factor)等核心参数
    3. 丰富的滤波器类型:内置多种常见音频滤波器类型,并提供数学函数计算最终信号曲线
    4. Web 化专业工具:将传统桌面音频软件的专有处理与可视化能力成功迁移到浏览器环境,安装简单(npm i dsssp)

    URL:https://dsssp.io/ DSSSP: React Library for Audio Equalizers & Filter Visualization

  13. 《React Suspense 边界触发机制与实战用法》

    《React Suspense 边界触发机制与实战用法》

    标签:#前端 #React #Suspense #LazyLoading #StreamingRendering #ViewTransition

    总结:
    React Suspense 边界在组件树中充当"加载守门员",当子组件通过 lazy 懒加载、用 use 读取 Promise、或加载带 precedence 的样式表时,边界会优雅地切换到 fallback UI。它与流式服务端渲染、ViewTransition 动画深度整合,还能配合 startTransition 避免已显示内容被强制替换,让加载体验从"闪屏"变成"渐进式揭晓"。

    文章要点:
    1. Suspense 不是万能检测器,它只捕获渲染阶段的挂起行为——Effect 或事件里的数据请求不会触发边界,得用 use 读取 Promise 或框架封装才行
    2. 七大触发场景一览:懒加载组件代码、Promise 数据读取、带 precedence 的样式表、流式 SSR 的大块 HTML、ViewTransition 期间的字体与图片加载、以及实验性的 defer CPU 密集型渲染
    3. 嵌套边界能打造"加载阶梯":外层骨架屏先撑住,内层内容逐层揭晓,避免整页白屏,还能让设计师的 loading 状态稿直接落地
    4. startTransition 是保屏神器:导航更新时标记为非紧急,React 会"忍一忍"新内容的挂起,不让已显示的 Layout 被 fallback 粗暴顶掉
    5. 配合 key 重置边界:切到不同用户资料时,给边界加 key 能让 React 识别为新内容,自动清掉旧状态,避免"张冠李戴"的残留显示
    6. 服务端容错兜底:流式 SSR 里组件抛错不会崩掉整个渲染,React 会找到最近的 Suspense 边界,把 fallback 塞进 HTML,客户端再尝试 hydrate
    7. 资源协调全家桶:ViewTransition 动画期间,Suspense 能同时等待数据、样式、字体、图片全部就位,让过渡动画开场就是完整画面,告别"先丑后美"的闪烁

    URL:https://react.dev/reference/react/Suspense#what-activates-a-suspense-boundary Suspense – React

  14. 《让React Compiler接管Memoization后,我踩了哪些坑》

    《让React Compiler接管Memoization后,我踩了哪些坑》

    标签:#前端 #React #ReactCompiler #Memoization #NextJS #ReactHookForm

    总结:

    作者在生产级Next.js项目中启用React Compiler v1.0的真实踩坑记录。编译器确实能自动处理大部分memoization,但"大部分"这个词背后藏着不少陷阱:React Hook Form的watch()因内部可变状态导致实时预览冻结;Chart.js的点击处理器在移除useCallback后出现数据过时问题;DevTools的Memo徽章仅表示组件被"处理"而非"成功优化"。核心结论是:迁移不是一键操作,需要先升级eslint-plugin-react-hooks、在feature分支启用、用E2E测试覆盖,并保留那些跨越React边界的显式hook。

    文章要点:

    1. React Compiler的本质是Babel插件:它通过为每个组件预分配扁平缓存数组(内部hook _c)来实现比手写useMemo更细粒度的自动memoization,让你可以删掉大部分显式hook
    2. React Hook Form的watch()直接翻车:启用编译器后,表单的实时预览完全冻结,原因是RHF依赖内部可变状态,编译器无法安全memoize。解决方案是用"use no memo"指令包裹useForm的调用
    3. 有些useCallback真的删不得:Chart.js的点击处理器在移除useCallback后,高并发下偶尔引用旧数据。这不是编译器bug,而是编译器的memoization节奏与外部库(按引用注册回调)的预期不一致,最终选择保留useCallback并加注释说明
    4. DevTools的Memo徽章会误导你:徽章只表示编译器"处理过"该组件,不代表优化成功。即使组件违反React规则(如直接修改props),徽章依然可能出现,真正没徽章的只有显式加了"use no memo"的组件
    5. 迁移有明确的正确顺序:先升级eslint-plugin-react-hooks到v7+并修复lint错误,再在feature分支启用编译器,最后用Profiler和E2E测试验证,不要依赖Memo徽章作为正确性信号

    URL:https://blog.logrocket.com/react-compiler-memoization-what-actually-broke/ I let React Compiler handle memoization: Here's what actually broke - LogRocket Blog

  15. 《水合不匹配的隐藏代价:一个错误如何让LCP从绿变红》

    《水合不匹配的隐藏代价:一个错误如何让LCP从绿变红》

    标签:#前端 #React #HydrationMismatch #LCP #CoreWebVitals #SSR

    总结:

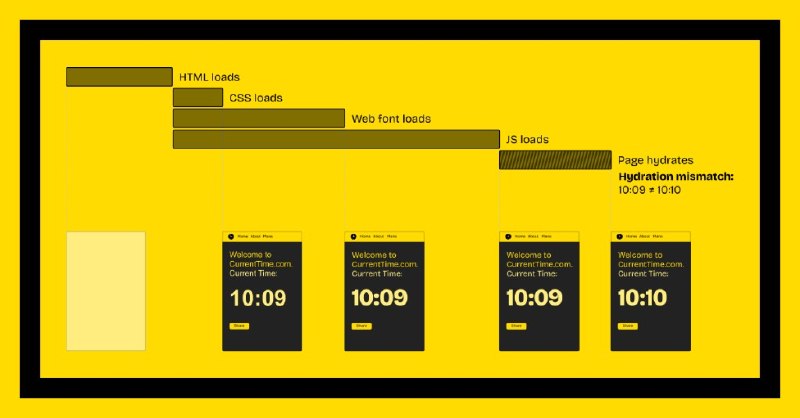
    文章揭示了React SSR中一个被严重低估的性能杀手:单个水合不匹配(Hydration Mismatch)就能让LCP从绿色直接跌到红色。核心逻辑由三个事实拼接而成——水合不匹配会触发整个DOM重新挂载;使用font-display: swap时,Web字体加载后文本会膨胀;而LCP只测量新加入DOM的元素,忽略已有元素的尺寸变化。三者叠加后,字体加载后的文本膨胀本应不影响LCP,但DOM重挂载让浏览器将其视为"新元素",导致LCP时间被记录到水合完成时(通常5秒以上),严重拖垮核心指标。

    文章要点:

    1. 水合不匹配会强制重挂载整个DOM:当服务端和客户端渲染结果不一致时,React不会局部修补,而是找到最近的Suspense边界并重新挂载整个子树;没有边界时整页重挂
    2. 字体加载导致文本膨胀是正常现象:使用font-display: swap时,系统字体切换到Web字体的过程中,相同字符的物理尺寸往往不同,文本会轻微变大或变小
    3. LCP只关心"新元素":浏览器记录LCP候选者时,仅在新元素加入DOM时重新评估;已有元素单纯尺寸变化不会触发更新,这是设计上的关键细节
    4. 三者叠加就是灾难:文本先因字体加载膨胀,再因水合不匹配被删除并重新插入DOM,浏览器将其识别为"更大的新元素",LCP时间瞬间跳到水合完成时刻
    5. 修复方案很直接:优先避免水合不匹配;如果实在无法避免,将不匹配元素包裹在Suspense边界内,限制重挂载范围,防止LCP候选元素被波及

    URL:https://3perf.com/blog/hydration-mismatch/ Hidden Cost of Hydration Mismatches

  16. 《TanStack Start 心智模型:给 Next.js 开发者的迁移指南》

    《TanStack Start 心智模型:给 Next.js 开发者的迁移指南》

    标签:#前端 #TanStack_Start #Next.js #React_Router #TypeScript #全栈框架

    总结:
    文章从一位资深 Next.js 开发者的视角,系统对比了 TanStack Start 与 Next.js App Router 的核心差异。核心心智模型翻转在于:Next.js 默认服务端优先、隐式约定驱动;TanStack Start 默认同构 React、显式声明边界。作者逐一对比了路由类型系统、数据获取、服务端函数、缓存策略、渲染模式、认证防护等关键维度,指出 TanStack Start 更适合高交互 SaaS 类应用,而 Next.js 在内容型站点和成熟生态上仍有优势。

    文章要点:
    1. 心智模型大翻转:Next.js 默认组件跑在服务端,需要显式标注 "use client" 才能上客户端;TanStack Start 默认组件同构(服务端+客户端都能跑),只有需要纯服务端逻辑时才用 createServerFn 显式声明,边界更清晰,不容易踩坑
    2. 路由类型系统碾压:Next.js 的文件路由是约定驱动,TypeScript 对参数无能为力;TanStack Router 会在构建时自动生成完全类型化的路由树,路径参数、搜索参数、loader 返回值全部类型推断,拼写错误直接编译报错
    3. 数据获取的"陷阱":Next.js 的 Server Component 只在服务端执行,天然安全;TanStack Start 的 loader 是同构的——SSR 时跑在服务端,客户端导航时跑在浏览器里,所以直接写数据库查询会泄露环境变量,必须用 createServerFn 包裹
    4. 缓存哲学更简单:Next.js 历史上有复杂的四层缓存模型,v16 改为 'use cache' 显式 opt-in;TanStack Start 只有路由 loader 缓存 + 可选的 TanStack Query,没有隐式魔法,哪里缓存、哪里失效一目了然
    5. 认证防护双层设计:beforeLoad 负责 UI 层面的重定向(用户体验),createServerFn 中间件负责数据层面的安全校验(真正的安全边界),两层职责分离,比 Next.js 把 edge middleware 和 action 内校验混在一起的方案更不容易遗漏
    6. Remix 与 RSC 现状:TanStack Start 的 RSC 支持仍处于实验阶段,实现方式也与 Next.js 不同(更像客户端获取 Flight payload 后组装),如果生产环境重度依赖 RSC,Next.js 目前更成熟
    7. 选型建议:内容型/营销站点选 Next.js;高交互 SaaS 后台、需要强类型安全、讨厌隐式缓存魔法的团队,TanStack Start 值得认真评估

    URL:
    https://www.adarsha.dev/blog/tanstack-mental-model-for-nextjs-developers TanStack Start: A Mental Model for Next.js Developers

  17. 《React Router v8 发布:最"无聊"的一次大版本升级》

    《React Router v8 发布:最"无聊"的一次大版本升级》

    标签:#前端 #React_Router #Remix #Vite #React19 #SPA_SSR #框架升级

    总结:
    React Router v8 正式发布,主打"最无聊的大版本升级"理念。v7 引入的 Framework Mode 已成熟,v8 在此基础上将多个 future flags 转正为默认行为,带来 40+ 项改进,包括中间件增强、路由模块拆分、类型安全的 href、Link 遮罩等。破坏性变更极少,升级路径平滑。团队同时宣布采用年度大版本发布节奏,并正式将 React Router v6 和 Remix v2 标记为生命周期结束(EOL)。

    文章要点:
    1. 升级超省心:v8 的破坏性变更极少,大部分改动在 v7 中就能提前完成,团队的目标是"让大版本升级尽可能无聊"
    2. 基线要求更新:最低支持 Node 22.22+、React 19.2.7+、Vite 7+,且改为纯 ESM 发布,tsconfig 目标更新至 ES2022
    3. Future Flags 转正:v8 移除了多个 future flags,其对应功能现在默认启用,比如中间件、透传请求、Vite Environment API 支持等
    4. Remix 走向新方向:Remix v0.x-2.x 的功能已合并回 React Router,Remix 3 将转型为真正的全栈零依赖 JS 框架,与 React Router 并行发展
    5. 年度发布节奏:从 v8 开始采用每年一次大版本发布,让升级更可预测、更稳定
    6. v6/v7 生命周期:v6 和 Remix v2 正式 EOL,不再接收安全更新;v7 继续接收安全补丁

    URL:
    https://remix.run/blog/react-router-v8 React Router v8

  18. 《为什么我放弃Next.js和RSC,回归传统SPA与独立后端》

    《为什么我放弃Next.js和RSC,回归传统SPA与独立后端》

    标签:#前端 #Web开发 #React #NextJS #React_Server_Components #SPA #架构设计 #安全 #TanStack #Hono

    总结:

    作者回顾了自己从Next.js忠实用户到拥抱App Router/RSC,最终回归传统SPA+独立后端的完整历程。文章深入分析了RSC架构带来的心智负担、序列化开销和安全风险,结合2025-2026年多起严重CVE漏洞,论证了将渲染框架与安全边界解耦的必要性,并分享了当前基于React Router+Vite+Hono的简洁技术栈。

    文章要点:

    1. Next.js的黄金时代:Pages Router时期心智模型清晰,服务端/客户端边界一目了然,文件路由简单易懂,部署零成本
    2. App Router带来的混乱:Server/Client Component区分成为负担,"use client"指令传染性强,开发/构建/生产环境缓存行为不一致,服务端客户端边界变得不可见
    3. 安全漏洞敲响警钟:2025年CVE-2025-29927中间件绕过(CVSS 9.1)、2025年底RSC核心包10分满分漏洞CVE-2025-55182、2026年初多起Server Function DoS漏洞,攻击面集中在服务端渲染和反序列化环节
    4. TanStack并非避风港:2026年5月TanStack遭遇供应链攻击,42个包被投毒,说明换框架不能免疫风险,减少依赖面才是关键
    5. 序列化是根本原因:RSC的"无缝"本质是分布式系统的序列化问题,函数、类实例、错误栈都无法透明穿越边界,反序列化不可信输入成为高危攻击面
    6. 当前架构选择:React Router框架模式+Vite纯SPA(仅营销页预渲染)+ Hono独立后端,API通过显式HTTP调用,无RSC负载,无服务端序列化
    7. 安全设计原则:认证授权在API层强制执行,前端中间件只做UX跳转,CORS/CSRF/验证码/限流全部在可控的后端实现,与渲染框架彻底解耦
    8. 核心收获:架构清晰可指认、无序列化税、前端攻击面趋近于零、后端语言自由选型、依赖更少爆炸半径更小——"无聊"在软件工程里是赞美

    URL:https://dev.to/zulikram/why-i-walked-back-from-nextjs-and-rsc-to-a-plain-spa-and-a-separate-backend-4k8p

  19. 《TanStack Router 与 Query 的最佳实践》

    《TanStack Router 与 Query 的最佳实践》

    标签:#前端 #React #TanStackQuery #TanStackRouter #数据获取 #SSR

    总结:
    本文详解了 TanStack Router 与 TanStack Query 的集成方案,核心思路是将 Router 的 Loader 视为"预取触发器",让 Query 接管全局缓存。通过关闭 Router 内置缓存、在 Loader 中预取 Query、组件中使用 useSuspenseQuery 或 useQuery 的组合策略,实现数据尽早获取、避免请求瀑布,同时兼容 SSR 流式渲染。作者强调始终使用 Query Hooks 而非 useLoaderData 获取数据,以维持自动重取、缓存失效和垃圾回收的正常运作。

    文章要点:
    1. Router 自带缓存仅限单路由,Query 缓存全局可跨路由共享,更适合多路由共用数据场景
    2. 在 Loader 中预取 Query 能让请求在组件渲染前甚至 JS 加载前就开始,配合 prefetch:'intent' 还能实现悬停预加载
    3. 关闭 Router 缓存(defaultPreloadStaleTime: 0)避免与 Query 缓存冲突,让 Query 独掌缓存策略
    4. 推荐用 useSuspenseQuery 配合 Router 的默认 Error/Pending 边界,组件只需专注"阳光路径"
    5. Loader 中不 await 更灵活:useSuspenseQuery 实现阻塞加载,useQuery 实现延迟加载,由组件自主决定
    6. SSR 场景下 useSuspenseQuery 更友好,支持流式渐进渲染;useQuery 需在 Loader 中 await 否则服务端无 markup
    7. 切勿用 useLoaderData 替代 Query Hooks,否则会导致自动重取、失效刷新和垃圾回收全部失效
    8. 将 Loader 视为"事件处理器"——只负责触发预取、不返回数据,是渐进优化性能的好心智模型

    URL:https://tkdodo.eu/blog/tan-stack-router-and-query TanStack Router and Query

  20. 《Storybook 10.4 发布》

    《Storybook 10.4 发布》

    标签:#前端 #DevTools #Storybook #React #TanStackReact #ReactNative #AIAgent #MCP

    总结:
    Storybook 10.4 聚焦 AI 辅助开发与团队协作提效。AI Agent 现在能自动完成复杂项目的初始化、Mock 配置、Stories 编写与测试验证;侧边栏新增变更检测过滤器,帮你秒速锁定受代码改动影响的组件;一键分享让非技术成员无需等待 PR 或 CI 就能即时查看工作进度。此外还带来 TanStack React 官方支持、React Native 隔离优化,以及实验性的 React Component Meta 分析器,组件识别率达 100%,热更新速度最高提升 81 倍。

    文章要点:
    1. AI 全自动配置:只需一句 Prompt,AI Agent 就能分析项目结构、生成 Storybook 配置、编写 MSW Mock 和交互测试,并自动验证渲染效果。已在 Excalidraw、Bluesky 等复杂项目验证可行。
    2. 侧边栏变更检测:新增 New、Modified、Related 三种过滤器,帮你秒速锁定代码变更波及的所有 Stories,特别适合 AI 生成代码后的快速审阅。
    3. 一键云端分享:点击 Share 按钮即可将当前 Storybook 发布到 Chromatic,设计师和产品经理不用等 PR 或 CI,点开链接就能直接看效果、提反馈。
    4. TanStack React 官方支持:全新 @storybook/tanstack-react 包,零配置接入类型安全路由与 Server Functions,由 Storybook 与 TanStack 核心团队联合打造。
    5. React Native 隔离升级:新增独立应用入口,通过环境变量自动切换,Storybook 代码与业务代码完全隔离,零配置起步且向后兼容。
    6. React Component Meta 实验特性:基于 Volar 和 TS Language Server 的新一代 Docgen,组件检出率 100%,开发模式热更新比旧方案快 43 到 81 倍,为 AI 提供更精准的组件元数据。

    URL:https://storybook.js.org/blog/storybook-10-4/ Storybook 10.4